大数据分析系统 (Apache Spark)
Apache Spark 部署模式旨在使用 Spark 库将空间分析引入数据科学家熟悉的环境,使他们能够通过新的或现有的分析工作流中的空间函数和流程来增加价值。 Apache Spark 提供分布式计算能力,支持访问各类数据集,具备强大的功能库,能够对结构化分析内容进行探索与交互,并生成可供利益相关方或后续业务流程使用的结果。
Esri 提供的 Spark 库 (ArcGIS GeoAnalytics Engine) 可为 Apache Spark 上的大数据分析系统模式提供支持。 ArcGIS GeoAnalytics Engine 使用 Apache Spark 访问 150 多个云原生地理分析工具和功能,以了解趋势、模式和相关性。 ArcGIS GeoAnalytics Engine 可以安装在个人计算机或独立的 Spark 集群上,但大多数组织倾向于在云中使用托管 Spark 服务。 这些云托管环境可简化大数据处理、实现可扩展性、优化成本、利用高级分析功能、确保安全性和合规性,并从云提供商提供的托管服务和支持中受益。 其中包括 Amazon EMR、Databricks、Azure Synapse Analytics、Google Cloud Dataproc 和 Microsoft Fabric。
除了 ArcGIS GeoAnalytics Engine 之外,Esri 还提供了一个用于空间大数据分析的替代 Spark 库,称为大数据工具包。 大数据工具包 (BDT) 是一款 Esri 专业服务解决方案,可提供一些独特的功能,并且可能适用于需要扩展空间功能和具有增强功能工具的某些场景。 有关详细信息,请参阅扩展功能。
相关资源:
基础架构
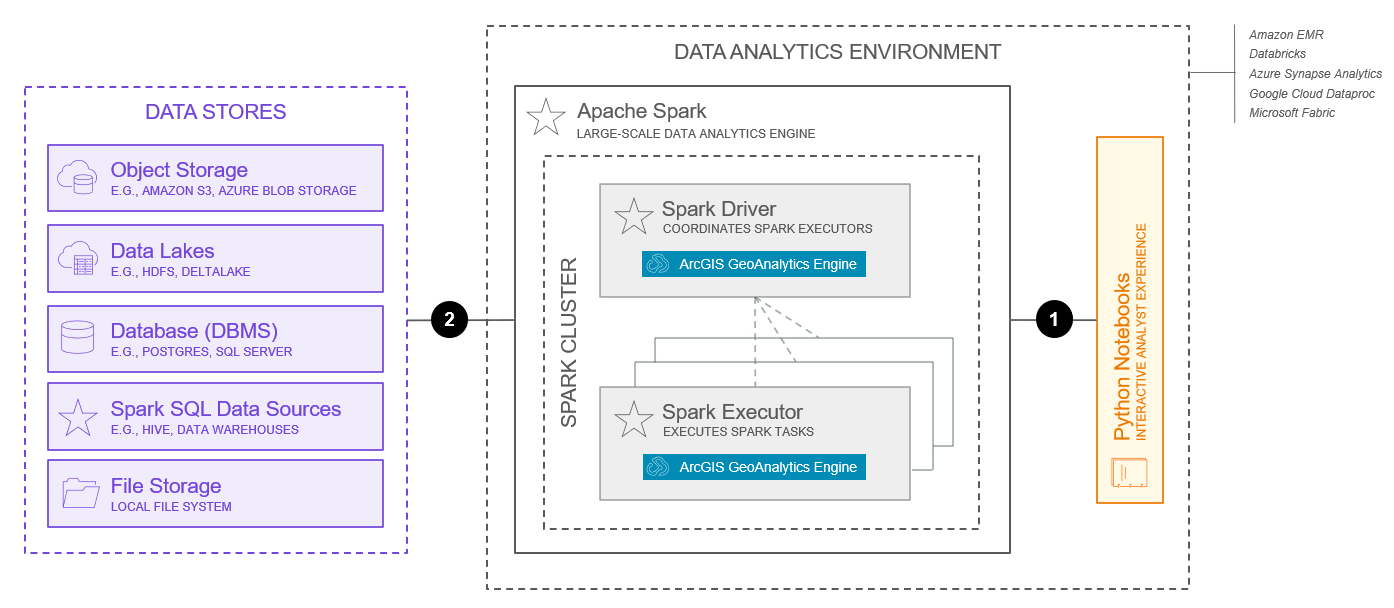
以下是使用 Apache Spark 的大数据分析系统的典型基础架构。
此逻辑示意图不应按原样用作您的系统设计。 在设计您的系统时,应综合考虑许多重要因素和设计选项。 有关详细信息,请参阅使用系统模式主题。 此外,下图仅提供了系统的基础功能;如需提供扩展功能,则可能需要附加系统组件。
上文所示功能反映了截至 2025 年 12 月可用的功能。
此架构的关键组件包括:
- 大数据分析系统的基础是 Apache Spark 环境。 Spark 环境包含运行分布式分析任务的节点集群。 ArcGIS GeoAnalytics Engine 可以在许多 Spark 环境中运行,包括本地部署、集群部署和云中的托管 Spark 服务。 支持的托管 Spark 服务包括 Amazon EMR、Azure Synapse Analytics、Google Cloud Dataproc、Databricks 和 Microsoft Fabric。 这些选项为已经在现有云环境中运行工作负载的组织提供了部署路径,包括 Amazon Web Services (AWS)、Google Cloud Platform (GCP) 和 Microsoft Azure 云提供商。
- ArcGIS GeoAnalytics Engine 是一个 Spark 插件以及一组函数和工具,可在 Apache Spark 集群内的节点上运行。 空间分析任务从 Spark 驱动程序发送到 Spark 执行程序,在那里执行分析工作。 Spark 执行程序通过 Spark 集群管理器管理。 ArcGIS GeoAnalytics Engine 支持 Standalone、Apache Mesos、Hadoop YARN 和 Kubernetes 集群管理器。 了解有关 ArcGIS GeoAnalytics Engine Spark 集群模式的详细信息。
- 除了 Spark 支持的数据源之外,GeoAnalytics Engine 还支持从一些常见的空间数据源加载和保存数据。 这些包括但不限于文件存储、对象存储、数据湖和数据库 (DBMS) 中的数据。 了解有关支持的数据存储和支持的数据源的详细信息。
- GeoAnalytics Engine 扩展了 PySpark(Spark 的 Python 接口),并使用 Spark DataFrame 以及自定义几何数据类型来表示空间数据。 GeoAnalytics Engine 附带多个 DataFrame 扩展模块,用于从 PySpark 支持的任何数据源以及 shapefile 和要素服务等数据源中读取数据。 GeoAnalytics Engine 还包括两个用于处理 DataFrame 的核心模块:SQL 函数和工具。 用户通常在其数据分析环境中运行 Python,通过Python 笔记本与大数据分析系统进行交互。 了解有关 ArcGIS GeoAnalytics Engine 入门的详细信息。
此架构中包含以下关键交互:
- PySpark Python 代码通常在数据分析环境中运行的 Python 笔记本中开发,作为应用程序捆绑并提交到 Spark 集群。 将作业提交到 Spark 集群的操作通常通过 TCP 执行。 了解有关提交 Spark 应用程序的详细信息。
- ArcGIS GeoAnalytics Engine 和数据存储之间的通信是双向的,允许在多个受支持的数据存储中访问和保存数据。 该通信的技术规格将取决于所使用的数据存储类型。 有关详细信息,请参阅 ArcGIS GeoAnalytics Engine 数据存储。
有关 ArcGIS GeoAnalytics Engine 与 Apache Spark 环境之间交互的其他信息,请参阅 ArcGIS GeoAnalytics Engine 产品文档。
功能
Apache Spark 上的大数据分析系统的功能如下所述。
基础功能
基础功能表示由大数据分析系统提供的最常见功能,这些功能由以上介绍的基础架构实现。
- 数据获取支持在执行分析任务时从许多受支持的数据存储访问数据。
- 借助空间连接和关系,可基于空间关系来组合来自两个 DataFrame 的行。 GeoAnalytics Engine 提供了多种机制来在空间上连接数据,以及分析和理解几何之间的空间关系。 了解有关空间连接和空间关系的详细信息。
- 时间步长和时态关系支持使用时间进行分析。 时间步长可将输入数据分割为独立执行分析的步骤,其中时态关系用于使用时空连接工具在时间上连接数据。 了解有关时间步长和时态关系的详细信息。
- 模式分析用于标识数据中的空间和时间模式。 ArcGIS GeoAnalytics Engine 包括许多用于模式分析的工具和 SQL 函数,包括检测事件、查找热点、查找相似位置和地理加权回归。
- 邻近分析用于确定空间数据与其他空间数据的接近程度。 ArcGIS GeoAnalytics Engine 包括许多用于邻近分析的工具和 SQL 函数,包括查找点聚类、按邻域分组和最近邻。
- 汇总分析用于将数据聚合或汇总到更高阶的数据结构中。 ArcGIS GeoAnalytics Engine 包括许多用于汇总分析的工具和 SQL 函数,包括聚合点、计算密度和范围内汇总
- 追踪分析适用于与移动对象相关的启用时间的点。 ArcGIS GeoAnalytics Engine 包括许多用于轨迹分析的工具和 SQL 函数,包括重新构建轨迹、计算动态统计数据和捕捉轨迹。
- 地理编码会将文本转换为地址和位置。 ArcGIS GeoAnalytics Engine 包括一个地理编码工具,该工具适用于 Spark DataFrame 中的地址。
- 网络分析有助于解决常见的网络问题,通常(但并非总是)针对街道网络。 ArcGIS GeoAnalytics Engine 包括许多用于网络分析的工具和 SQL 函数,包括创建服务区、查找最近设施点和生成 OD 矩阵。
- 数据管理支持对大数据中的几何和其他字段进行操作。 ArcGIS GeoAnalytics Engine 包括许多用于数据管理的工具和 SQL 函数,包括计算字段工具和许多扩展 Spark SQL API 的空间 SQL 函数。
- 分析结果的制图和可视化是提供上下文并帮助发现模式、趋势和关系的强大步骤。 可视化和制图类似于使用非空间数据绘制图表。 这是一种验证您的分析、迭代并创建引人入胜的可共享结果的方式。 ArcGIS GeoAnalyics Engine 使您能够在 Python 笔记本中可视化数据集。 了解有关可视化分析结果的详细信息。
扩展功能
添加扩展功能通常是为了满足特定需求或者支持行业特定的数据模型和解决方案,并且可能需要附加软件组件或架构注意事项。
- 栅格分析支持处理栅格数据的分析函数和处理器。 ArcGIS GeoAnalytics Engine 尚不支持栅格分析,但是,Esri 大数据工具包确实提供了一些基本的栅格分析处理器,这些处理器可将栅格和矢量数据组合在一起(例如擦除栅格和区域制表)。 有关更高级的栅格和影像分析,请参阅影像数据管理和分析系统模式。
- ArcGIS GeoAnalytics Engine 尚不支持自定义分析工具,但可以使用 Esri 大数据工具包 (BDT) 进行开发。 BDT 可以通过修改或创建分析工具和函数进行扩展。
- ArcGIS 支持数据发布和分析结果的托管,但这被视为超出了大数据分析系统的范围。 发布和共享通常由自助制图、分析和共享系统解决;但是,许多 ArcGIS 系统模式都支持发布和共享分析结果。 了解有关使用、集成和组合系统模式的详细信息。
注意事项
以下注意事项将 ArcGIS 优化架构框架的支柱应用于 Apache Spark 上的大数据分析系统。 此处提供的信息并不详尽,而是强调了设计和/或实施这种特定的系统和部署模式组合的关键注意事项。 了解有关 ArcGIS 优化架构框架的架构支柱的详细信息。
可靠性
可靠性可确保您的系统提供业务以及客户和利益相关者所需的相应级别服务。 有关详细信息,请参阅可靠性支柱概览。
- 可靠性几乎完全由 Apache Spark 环境处理。 需要考虑许多因素,例如集群管理器的选择,这也将根据 Spark 的安装位置(本地、集群或托管云服务)的不同而存在显著差异。
- 与其他系统相比,SLA 在大数据分析系统中不太常见。
安全性
安全性可保护您的系统和信息。 有关详细信息,请参阅安全性支柱概览。
- 支持使用 Esri 提供的用户名和密码或许可文件来授权使用大数据分析系统。
- 身份验证、加密、日志记录和其他安全注意事项通常在 ArcGIS GeoAnalytics Engine 软件之外处理,无论是在数据源还是在 Apache Spark 环境中。 了解有关 Spark 安全性的详细信息。
性能和可扩展性
性能和可扩展性旨在优化用户对系统的整体体验,并确保系统能够扩展以满足不断变化的工作负载需求。 有关详细信息,请参阅性能和可扩展性支柱概览。
- 利用基于 Apache Spark 的环境的优势在于其分布式计算功能。 许多组织都有云托管环境管理员,他们了解控制集群和托管分析使用的计算资源规模的概念。 空间大数据分析本身并没有什么不同。 大规模执行分析会产生相关成本。 组织应进行成本效益分析,以确定他们希望分配给空间分析的计算资源。
了解有关调整 Spark的详细信息。
自动化
自动化旨在减少在手动部署和运营任务上花费的精力,从而提高运营效率并减少人为引入的系统异常。 有关详细信息,请参阅自动化支柱概览。
- 分析通常是迭代的,需要在分析执行之间进行人工审核和干预。 但是,在某些情况下,可能需要自动化和/或计划分析的执行。
- 云托管的 Apache Spark 环境非常常用,它提供额外的自动化选项,可以帮助简化整体操作和使用。
- 由于大数据分析系统的主要应用程序或接口是 Python,并且 Apache Spark 提供了用于将应用程序提交到集群的脚本,因此分析提交的自动化简单明了且十分灵活。
- Spark 集群管理器还支持跨应用程序计划作业。 云中的集群管理器和托管 Spark 服务有不同的选项,其中许多选项提供不同的功能。
集成
集成可将此系统与其他系统连接起来,以实现企业级服务交付与组织效能提升。 有关详细信息,请参阅集成支柱概览。
- 集成在大数据分析系统模式中本身就是一个内在特性,主要在数据层进行集成,同时还包括与 ArcGIS GeoAnalytics Engine 以及 Apache Spark 环境或云端托管的 Spark 服务的集成。
- 将其与自助制图、分析与共享系统或其他 ArcGIS 系统模式集成,也是企业内部将分析结果发布和共享给其他用户和系统的常见做法。 了解有关使用、集成和组合系统模式的详细信息。
可观测性
可观测性提供了对系统的可见性,由此确保操作人员和其他技术角色能够使系统以健康、稳定的状态运行。 有关详细信息,请参阅可观测性支柱概览。
- Apache Spark 上大数据管理系统的可观测性通常集中在了解底层基础设施的使用情况和性能,以及了解大型批量分析作业的状态和进度。 监控底层基础设施的使用和性能的方法将取决于所使用的 Apache Spark 环境。 云托管环境之所以受欢迎,部分原因是它们在可观测性方面的优势。 Apache Spark 作业的监控由 Apache Spark 提供。
其他
在 Apache Spark 上设计和实施大数据分析系统的其他注意事项包括:
- 成功的运作需要对 Apache Spark 的深入理解和坚定专注。 还需要对大型分布式数据和分析概念有深入的理解。
相关资源: